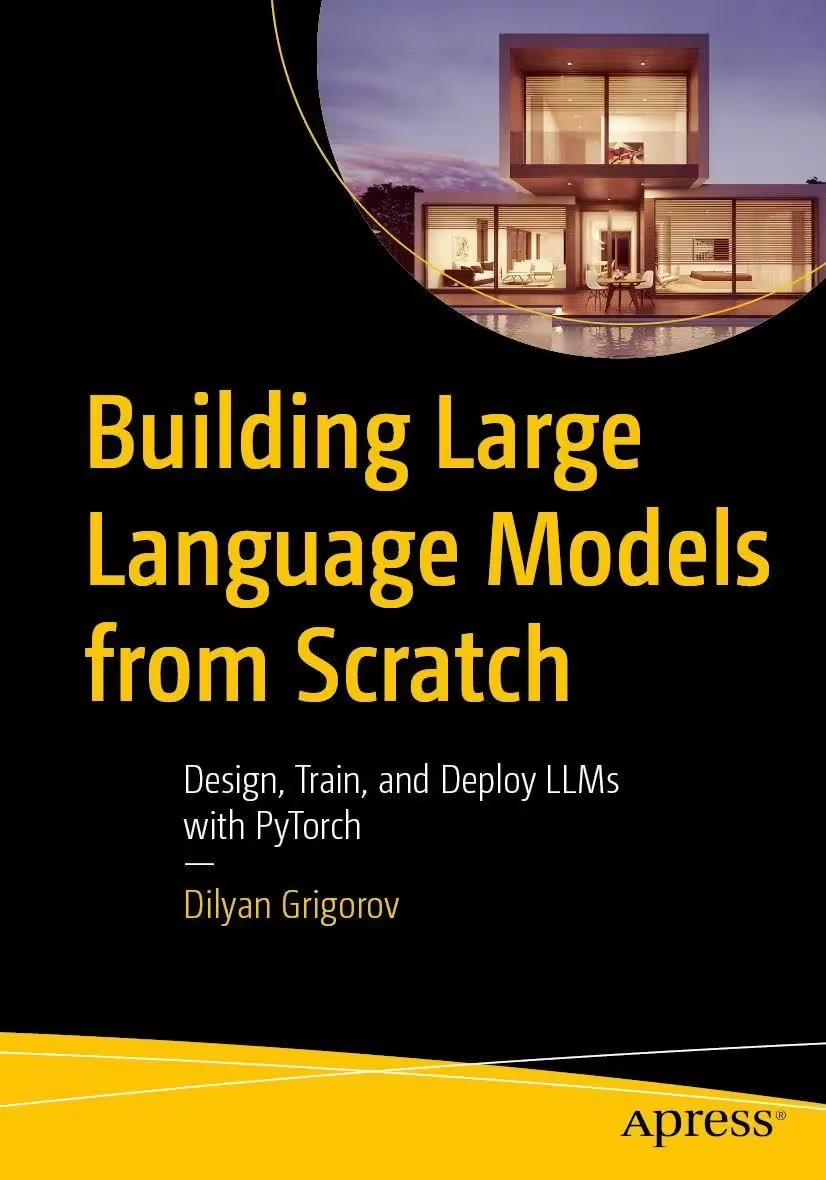
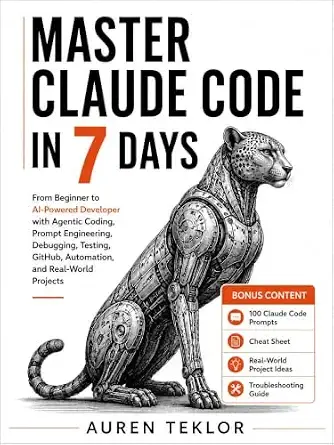
本书是一本完整的实践指南,用于设计、训练和部署您自己的大型语言模型 (LLM)——从标记化的基础到微调和强化学习的高级阶段。它是为开发人员、数据科学家和人工智能从业者编写的,它将核心原则和最先进的技术联系起来,以罕见、透明的方式展示现代变压器如何在表面下真正工作。
从基础知识开始,您将学习如何使用 Python 和 PyTorch 设置环境、管理数据集以及实现张量、嵌入和梯度下降等关键基础知识。然后,您将深入了解现代模型的架构核心,包括 RMS 归一化、旋转位置嵌入 (RoPE)、缩放点积注意力、分组查询注意力 (GQA)、专家混合 (MoE) 和 SwiGLU 激活,每个模型都经过深入探索并在代码中逐步构建。随着您的进步,本书介绍了自定义 CUDA 内核集成,教您如何优化关键组件以提高 GPU 级别的速度和内存效率,这是扩展现实世界 LLM 的基本技能。您还将掌握定义当今领先模型的培训阶段
预训练 – 建立一般语言和语义理解。
训练中 – 扩展特定领域的能力和适应性。
监督微调 (SFT) – 将行为与精心策划的任务驱动数据保持一致。
基于人类反馈的强化学习 (RLHF) – 通过基于奖励的人类对齐优化来改进响应。
最后几章将指导您完成数据集准备、过滤、重复数据删除和训练优化,最终使用用于文本生成和推理的自定义 TokenGenerator 进行模型评估和现实世界提示。
读完本书后,您将拥有构建、训练和部署自己的基于 Transformer 的模型的知识和信心,并具备理论深度和实践专业知识,以便在快速发展的人工智能世界中进行创新。
你将学到什么
如何使用 PyTorch 配置和优化您的开发环境
标记化、嵌入、标准化和注意力机制的机制。
如何从头开始实现 RMSNorm、RoPE、GQA、MoE 和 SwiGLU 等转换器组件。
如何集成自定义 CUDA 内核以加速转换器计算。
完整的 LLM 训练流程:预训练、训练中、监督微调和RLHF。
数据集准备、重复数据删除、模型调试和 GPU 内存管理技术。
如何针对实际任务训练、评估和部署完整的类似 GPT 的架构。
密码:sanet.st@Mercurybooks
感谢您的理解和持续支持。
| 版本 | 兼容平台 | 语言 | 大小 | 更新时间 | 下载 |
|---|---|---|---|---|---|
| LB 8405 | 英文 | 20.6MB | 2026-04-28 |
评分及评论
暂无评分
来评个分数吧