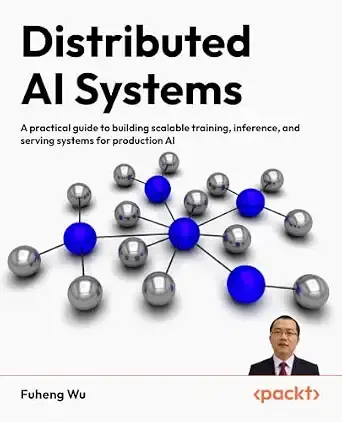
分布式人工智能系统

分布式人工智能系统

立即下载
免费资源
暂无评分
73
0
为生产型人工智能构建可扩展的训练、推理和服务系统的实用指南

通过训练框架、推理引擎和编排工具的实践经验来学习分布式 AI,为现代大规模 AI 构建可用于生产的训练、推理和服务系统。

随书免费:无 DRM 的 PDF 版本 + 访问 Packt 的下一代阅读器*

主要功能

  • 了解 GPU 硬件、高速互连和并行策略
  • 每章末尾都有实践练习
  • 通过高级优化和内存管理部署高性能推理
  • 利用作业调度程序、编排和可观察性构建生产服务堆栈

书籍说明

随着人工智能模型的参数增长到数万亿个,分布式系统对于训练和服务它们至关重要。许多资源涵盖了该领域的一些片段,但没有一个资源提供从分布式训练到推理和生产部署的完整路径。本书通过以生产为中心的实用示例填补了这一空白。

它从 GPU 和内存估计、数据准备以及 GPU 架构、互连和核心并行策略的概述开始。学习训练技术,包括单节点和多节点设置的数据并行性、内存高效扩展的参数分片以及减少大型模型内存使用的方法。

下一节将介绍分布式推理和部署。您将使用优化的注意力、缓存、算子融合和基于路由器的设计来构建高性能系统。您将通过 GPU 感知编排在调度程序和容器平台上进行部署,并组装强调可靠性、可扩展性和可观察性的生产堆栈。最后一部分涵盖基准测试、性能调优以及 MoE 模型、边缘云协调和高级并行性等趋势。

到最后,您将能够构建从单个 GPU 扩展到大型集群的分布式 AI 系统。

你将学到什么

  • 估算训练和推理的内存和计算要求
  • 了解 GPU 硬件、互连和并行策略
  • 利用并行和分片技术实施分布式训练
  • 构建具有批处理和内存管理功能的生产推理系统
  • 通过集群编排和优化的 GPU 调度进行部署
  • 创建具有路由和可观察性的生产服务堆栈
  • 使用行业标准方法对分布式系统进行基准测试
  • 探索新兴模型趋势、扩展策略和未来路径

这本书适合谁

本书专为需要大规模训练或服务大型 AI 模型的 ML 工程师、AI 研究人员和 DevOps 专业人员而设计。平台工程师、HPC 集群管理员和云架构师也会发现它对于提升他们的技能非常有价值。

需要对 Python 和 PyTorch 有基本了解才能开始。具有分布式系统、集群调度程序或容器编排方面的经验会有所帮助,但不是必需的 – 本书从头开始介绍这些概念,从资源估计、数据准备和硬件基础知识开始。

目录

  1. 现代分布式人工智能简介
  2. GPU 硬件、网络和并行策略
  3. 使用 PyTorch DDP 进行分布式训练
  4. 通过完全分片数据并行 (FSDP) 进行扩展
  5. DeepSpeed 和 ZeRO 优化
  6. 分布式推理基础知识和 vLLM
  7. SGLang 和高级推理架构
  8. 适用于 AI 工作负载的 Kubernetes

(注意:请使用“阅读示例”选项来查看更多章节)

其他信息

收录者
发布日期
8月21日
类别
计算机与技术
软件名称
分布式人工智能系统
探索
Ebooks
语言
英语
上传者
Loyce Bosco
格式
True PDF
页码
560
编码
978-1807301712
作者
Fuheng Wu
版本
2026
出版商
Packt Publishing - ebooks Account

下载版本

版本 兼容平台 语言 大小 更新时间 下载
LB 8173 英文 31.3MB 2026-08-21
温馨提示:本资源来源于互联网,仅供参考学习使用。若该资源侵犯了您的权益,请联系我们处理。

评分及评论

暂无评分

来评个分数吧

  • 5星
  • 4星
  • 3星
  • 2星
  • 1星

分布式人工智能系统