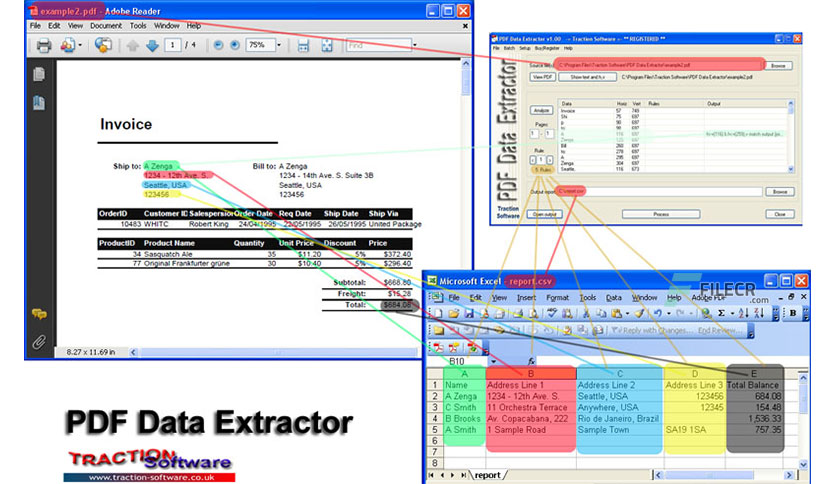
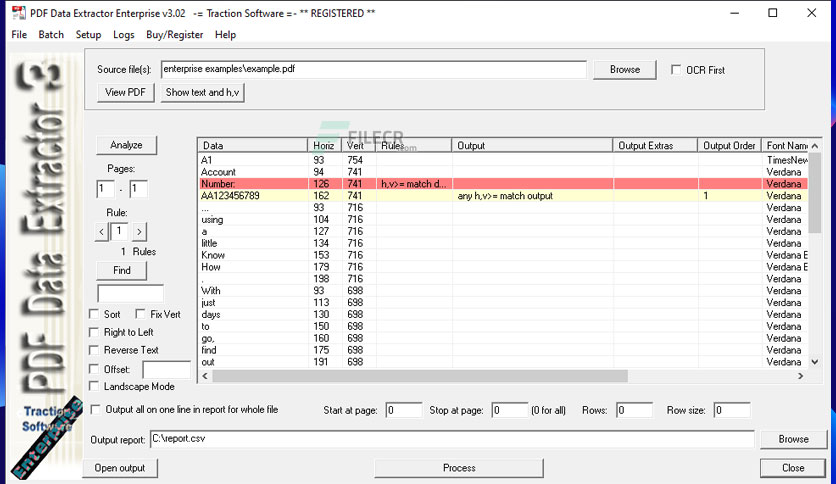
免费下载适用于 Windows 的 PDF Data Extractor 完整版独立离线安装程序。它可以从 PDF 中提取某些文本信息。
如果您有一份 PDF 声明,需要提取帐号、姓名和地址等数据并将其输出到 Excel CSV 文件中,那么这将是一个理想的产品。它使用水平和垂直文本位置匹配,对于更高级的匹配,它具有用于条件匹配等的规则系统。
仅当帐号:文本位于同一页时才进行匹配。它还可以合并不同的字段,因此名字和姓氏可以作为 CSV 文件中的一个字段输出。有许多选项可用:数据提取、OCR pdf 选项、OCR 数字校正、调整倾斜 pdf 页面选项、对其他语言文件的完整 Unicode 支持,例如
希伯来语,从右到左阅读顺序选项,页面上单词的偏移量,用于处理切碎的扫描 PDF、数字、日期和文本。金钱/日期/地址/电子邮件/电话号码/号码过滤、Smart Adobe Reader PDF 高亮显示设置、使用数据输出文件名、模式匹配、查找匹配描述代码的数据文件、数据列顺序分配、在命令行上运行、标题输出、页码字段、文件名字段、要处理的文件批量列表、32 位和 64 位版本。
此外,现在可以根据提取的数据重命名文件或将文件复制到新位置。企业版还支持:热文件夹多线程监控、NT 服务后台支持、用于直接从 pdf 数据更新数据库的 SQL Server 数据库插入支持,以及针对提取的数据的其他 DOS 命令,以实现完整的企业灵活性。
| 版本 | 兼容平台 | 语言 | 大小 | 更新时间 | 下载 |
|---|---|---|---|---|---|
| 3.06 | 英文 | 84.0MB | 2024-10-29 | ||
| 3.04 | 英文 | 83.9 MB | 2023-01-27 | ||
| 3.03 | 英文 | 83.9 MB | 2023-01-01 | ||
| 3.02 | 英文 | 84 MB | 2022-07-27 | ||
| 1.06 | 英文 | 6.2 MB | 2020-02-21 |
评分及评论
暂无评分
来评个分数吧